Revisado por Iván Quintas, Editor de IA News
Orquestación multi-agente en Orca: tasks, dispatch y gates
Runs, tasks, dispatches y decision gates: el bucle supervisado de Orca para que un coordinador dirija agentes CLI de verdad, con worker_done y ask.
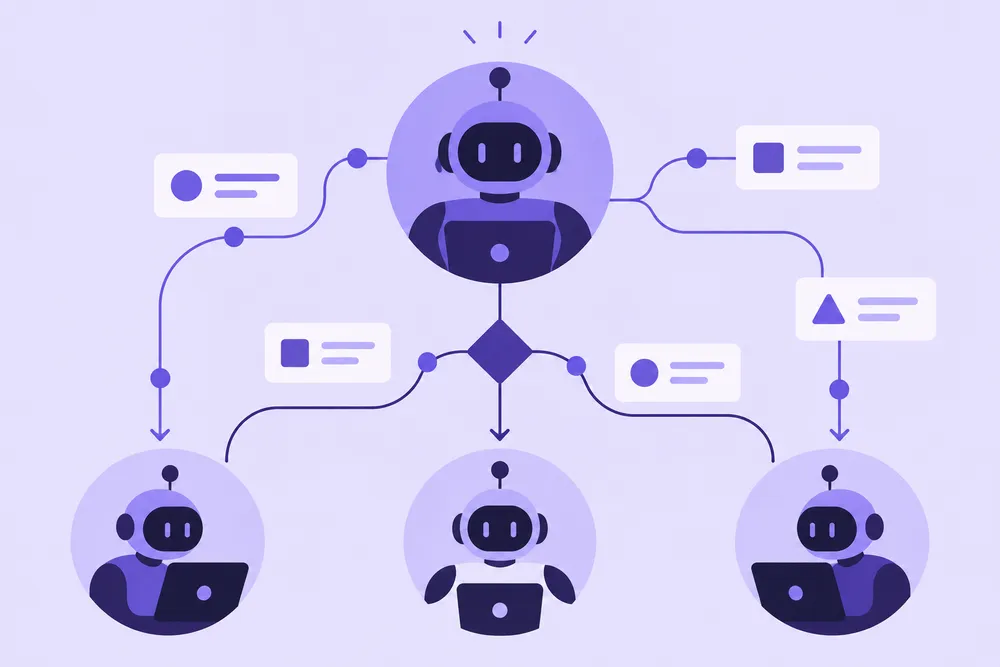
En los cuatro tutoriales anteriores cubrimos qué es Orca, los worktrees, la configuración de agentes y el Design Mode. En todos ellos hay un patrón en común: el coordinador eres tú. Tú partes el trabajo, tú miras los terminales, tú decides qué se mergea.
La orquestación de Orca existe para cambiar eso: es su capa de coordinación estructurada entre agentes — mensajes persistentes, tareas con estado y dependencias, dispatch con ciclo de vida, workers supervisados y gates de decisión. Un coordinador (tú o un agente) dirige a los demás con estado real en vez de mirando scrollback.
Este tutorial cierra la serie, y es el más avanzado de los cinco. Vamos con calma.
Lo que necesitas antes de empezar
- La serie anterior dominada — en particular los worktrees y los agentes configurados
- El runtime de Orca corriendo —
orca status --jsondebe responder - La feature experimental activada — la orquestación vive en Settings > Experimental. Sin activarla, los comandos
orca orchestrationno están disponibles
Un aviso honesto antes de invertir tiempo: es una feature experimental. Los comandos de este tutorial están verificados contra la versión actual del CLI, pero pueden cambiar entre versiones — la propia guía oficial documenta protocolos de migración para no romper runs vivos.
Los cuatro conceptos
La orquestación de Orca se entiende con cuatro piezas:
- Run — el espacio de nombres y el buzón del coordinador. Es duradero, pero no programa workers: no hay scheduler mágico. Un Run se crea con un objetivo y ahí vive tu inbox.
- Task — la unidad de trabajo, con estado (
pending,ready,dispatched,completed,failed,blocked) y dependencias: puedes construir un DAG con--depsy--parent. - Dispatch — un intento de tarea asignado a un terminal. El dispatch es la autoridad del ciclo de vida: si un worker informa de algo, lo hace contra su dispatch.
- Worker supervisado — un terminal de agente con un preámbulo inyectado que le obliga a reportar: hace la tarea, puede preguntar con
ask, y al terminar envía exactamente unworker_donecon outcome explícito.
Los mensajes que circulan tienen tipos: status, question, worker_done, escalation, heartbeat, merge_ready… y las piezas se manejan desde orca orchestration, que son llamadas RPC al runtime.
Orquestar no es hacer un handoff
Antes de lanzarte, el límite que la documentación repite una y otra vez — y que conviene interiorizar:
- Handoff (“dale esto a otro agente”): transfieres la propiedad y dejas de mirar. Se resuelve con
worktree create --agent ... --prompt ...y adiós. Es lo que hicimos en el tutorial 3 con las estrategias de división de trabajo. - Orquestación supervisada: solo cuando pides explícitamente supervisar, monitorizar, esperar resultados, coordinar un DAG, usar gates o mantener un ask/reply.
Si pides un handoff, no crees tareas ni dispatches ni esperes worker_done: el handoff no crea obligaciones de ciclo de vida. Si pides “lanza tres agentes y dime cuándo acaben, y si hay dudas pregúntame”, eso ya es orquestación. La diferencia no es pedantería: determina si el sistema deja estado de tracking y si los workers reportan.
El bucle supervisado, de arriba a abajo
El patrón central es siempre el mismo: crear el Run, crear TODAS las tareas, arrancar los workers independientes, y luego esperar y procesar en bucle.
Paso 1 — Run y tareas:
orca orchestration run-create --objective "preparar release 1.4 del checkout" --json
orca orchestration task-create --spec "Refactor del módulo de pagos: extraer la pasarela a un servicio propio" --json
orca orchestration task-create --spec "Tests e2e del flujo de compra" --json
orca orchestration task-create --spec "Actualizar CHANGELOG y docs del release" --deps '["<id_de_la_task_1>"]' --json
La tercera tarea depende de la primera (--deps): no se puede despachar hasta que el refactor termine. El DAG queda declarado, no en tu cabeza.
Paso 2 — workers. El comando moderno es worker-start, que compone worktree + terminal + readiness + dispatch en uno:
orca orchestration worker-start --task <task_1> --worktree new-child --name refactor-pagos --agent codex --setup run --json
orca orchestration worker-start --task <task_2> --worktree current --agent claude --json
Fíjate en el matiz: new-child crea un worktree hijo aislado (lo que vimos en el tutorial 2), mientras que current abre un terminal de agente nuevo en el worktree actual — para trabajo paralelo no siempre necesitas checkouts separados. Tú eliges la topología; Orca no la infiere.
Paso 3 — esperar y procesar:
orca orchestration check --wait --types worker_done,escalation,question --timeout-ms 900000 --jsonEsa espera devuelve un lote de mensajes (el más antiguo sin confirmar). Se procesan todos, se responde lo que haya que responder, se liberan los workers que hayan terminado — y solo entonces se confirma con --ack y se vuelve a esperar:
orca orchestration worker-release --dispatch <dispatch_id> --json
orca orchestration check --ack <delivery_id> --wait --types worker_done,escalation,question --timeout-ms 900000 --json
El bucle acaba cuando todos los dispatches esperados se han establecido. No hay que contar lotes: hay que contabilizar dispatches.
El worker reporta: worker_done, ask y heartbeat
Cuando worker-start (o dispatch --inject) entrega la tarea, el worker recibe un preámbulo con sus IDs. Al terminar, reporta exactamente una vez:
orca orchestration send --type worker_done --subject "tests verdes" --body "Añadidos 12 tests e2e del checkout; todos pasan; queda cubrir cupones" --task-id <task_id> --dispatch-id <dispatch_id> --outcome succeeded --files-modified "e2e/checkout.spec.ts" --jsonRegla dura: el outcome es explícito (--outcome succeeded o --outcome failed) — nunca se comunica un fallo solo en prosa. Un worker_done válido marca tarea y dispatch como completadas automáticamente.
Y si el worker se atasca a mitad:
orca orchestration ask --question "¿Uso la pasarela sandbox o la real?" --options "sandbox,real" --timeout-ms 600000 --json
# El coordinador responde:
orca orchestration reply --id <message_id> --body "sandbox" --json
ask es una pregunta bloqueante del worker al coordinador — la pregunta se queda pendiente si el coordinador no está, y se reanuda por su ID, no preguntando otra vez.
Gates: decisiones que el coordinador no delega
Los gates de decisión son puntos de parada gestionados por el coordinador dentro del DAG de tareas. No sirven para responder a un ask (para eso está reply): sirven para formalizar una decisión sobre cómo sigue el plan:
orca orchestration gate-create --task <task_3> --question "¿Merge directo a main o PR con revisión?" --options '["merge","pr"]' --json
orca orchestration gate-resolve --id <gate_id> --resolution "pr" --json
Con el gate resuelto, el coordinador sabe qué hacer con la tarea (despachar el merge o abrir PR). Es el equivalente formal de “espera, ¿cómo seguimos?” — pero con trazabilidad en el estado de orquestación, no en una conversación que se pierde.
Reglas que te ahorran desesperación
La guía oficial de orquestación trae reglas que solo se aprenden a hostazos. Ahí van las que más duelen:
- Un timeout de
check --waitno es un fallo. Es un checkpoint. Las tareas reales de código duran 15-60 minutos; se usan esperas en ventana corrida, no sondeos consleep. - Un worker callado no es un worker parado. Heartbeats y actividad en el terminal significan vivo. Nunca cierres un worker por no haber terminado aún — y jamás lo mates por silencio.
- Tres fallos consecutivos en una tarea y salta el circuit breaker: la tarea se marca
failed. Se reintenta conworker-start --retry-of <dispatch>, eligiendo explícitamente dónde y con quién. worker-releasees limpieza post-completación, no cancelación. Preserva la salida inspeccionable (worker-readsigue funcionando tras liberar) y solo cierra el terminal exacto de ese dispatch.- Cadenas de dependencia cortas: la guía recomienda no pasar de 3-4 pasos y despachar en oleadas paralelas, usando
task-list --readycomo memoria externa del coordinador.
Workers remotos y piezas de repuesto
--on <entorno>lanza el worker en otra máquina conectada (por ejemplo, el Run vive en tu Mac y el worker en un servidor Windows): el Run y las tareas siguen siendo tuyos; el resto de comandos se enrutan por dispatch ID.worker-read --dispatch <id> --limit 80devuelve el transcript real del agente cuando Orca puede probarlo, y salida de terminal acotada cuando no. Nada de adivinar por scrollback.dispatch --injectsigue existiendo como camino de bajo nivel para topologías queworker-startno expresa (agentes con argv custom, terminales que ya existen).
Cuándo NO orquestar
Para cerrar honesto, lo mismo que al principio pero invertido:
- Tarea simple o única → un worktree con un agente (tutorial 3) y ya
- Trabajo paralelo sin dependencias → los worktrees + diff viewer bastan
- “Dale esto a otro agente” → handoff, no orquestación
- Tareas pequeñas con un coordinador agente → el coordinador consume tokens también: a veces sale más caro el coordinador que el trabajo
La orquestación brilla cuando hay un DAG real (dependencias), varias oleadas de workers, decisiones que hay que dejar trazadas y coordinación que se cae si la llevas en la cabeza. Es la diferencia entre tener varios agentes y tener un equipo.
La serie, completa
Con esto, la serie de Orca en español queda cerrada:
- Orca IDE: el primer ADE para agentes de código
- Worktrees en Orca: aísla a tus agentes
- Configurar agentes: Claude Code, Codex y Hermes juntos
- Design Mode: cómo tu agente ve y edita tu UI
- Orquestación multi-agente: tasks, dispatch y gates
Del primer worktree a un DAG con gates. Lo siguiente natural son las recetas oficiales (racing de tres agentes, revisión de diffs línea a línea), que caen solas una vez dominados los cinco tutoriales.
Fuentes originales: Orca Docs — Orchestration, Orca Docs — Skills registry & MCP, skill orchestration (stablyai/orca), repo stablyai/orca en GitHub.
¿Te ha servido? Márcanos como fuente preferida en Google y verás antes nuestros artículos en Noticias destacadas, AI Overviews y AI Mode.
📎 Fuente original: Orca Docs ↗