Revisado por Iván Quintas, Editor de IA News
Cómo montar tu primer equipo de agentes con Claude Opus 5.5
Orquestador, especialistas y un crítico con el Claude Agent SDK: permisos mínimos, effort por rol, tope de gasto y un reloj para que el equipo acabe antes.
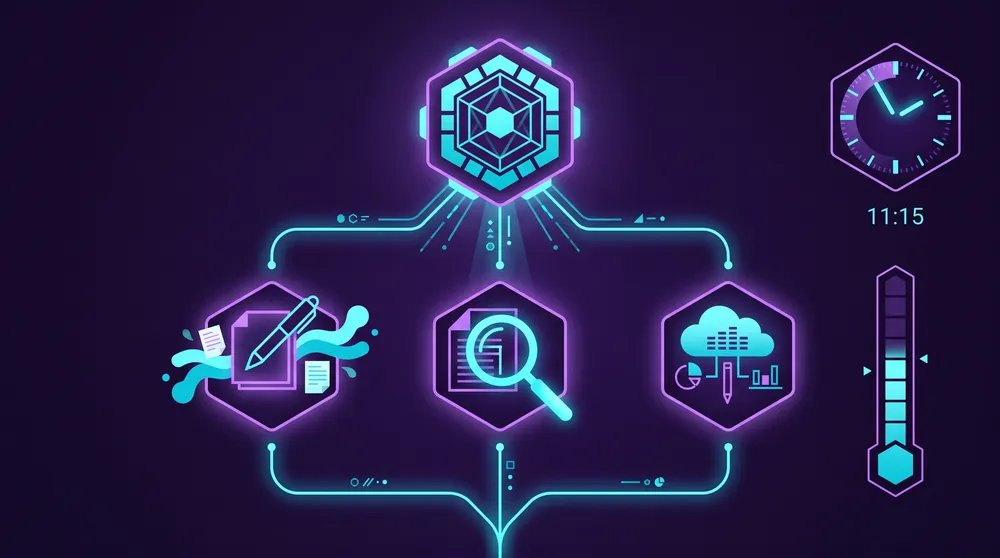
La mayoría de los “sistemas multiagente” que se ven en demos son caos caro: cinco agentes con roles vagos, todos los permisos, sin tope de gasto y pasándose contexto a medias. Es lo que sostiene Khairallah AL-Awady en un artículo largo en X, y tiene razón en lo básico: el fallo suele estar en la arquitectura, no en el modelo.
Esta guía recoge su enfoque, pero cada dato lo hemos comprobado contra la documentación de Anthropic: la guía de subagentes del Agent SDK y la guía de prompting de Claude Opus 5.5. Hemos dejado fuera las cifras de benchmarks del artículo original que no aparecen en esas fuentes.
Primero: probablemente no necesitas un equipo
Un equipo añade coordinación, más llamadas, más tokens y más formas de fallar. Según la documentación del SDK, delegar en subagentes da cuatro ventajas, y solo compensa si al menos una está haciendo trabajo real:
- Aislamiento de contexto: el subagente puede leer cincuenta páginas y al agente principal solo le llega su mensaje final.
- Paralelismo: las tareas independientes tardan lo que la más lenta, no la suma de todas.
- Instrucciones especializadas: cada rol tiene su propio system prompt sin ensuciar el del orquestador.
- Restricción de herramientas: una herramienta que no le das a un subagente no existe en su sesión.
Si tu tarea es un solo trabajo con una forma clara de comprobarlo, un único agente bien configurado será más rápido y barato.
Por qué Opus 5.5 cambia las cuentas
- Precio: 4 dólares por millón de tokens de entrada y 20 de salida, con lecturas de caché al 5% del precio de entrada. Un equipo multiplica el consumo, así que un modelo frontera más barato cambia qué equipos salen rentables.
- Effort: el valor por defecto es
medium, y Anthropic afirma que a ese nivel iguala o supera a Opus 5 enhighen programación y trabajo de conocimiento. Los trabajadores pueden ir ligeros. - Conciencia del tiempo: la guía de prompting dice que Opus 5.5 “presta mucha atención a la información sobre el tiempo transcurrido” y puede usarla para paralelizar mejor en equipos de agentes. Lo usarás en el paso 6.
La anatomía: tres roles
- Orquestador: recibe el objetivo, lo divide, asigna cada parte y monta el resultado. No hace el trabajo de fondo y es el único agente con el que hablas.
- Especialistas: cada uno hace una cosa concreta. Un investigador que solo busca y verifica, un escritor que solo redacta a partir de material verificado.
- Crítico: revisa el resultado contra un estándar y lo devuelve si no llega. Es el rol que casi todo el mundo se salta y el que separa una demo de algo que puedes usar.
Paso 1: instala el SDK
python3 -m venv .venv
source .venv/bin/activate
pip install claude-agent-sdk
export ANTHROPIC_API_KEY=tu-api-key
En TypeScript es npm install @anthropic-ai/claude-agent-sdk. El SDK lee la clave del entorno del proceso y no carga ficheros .env por su cuenta. Si vas a construir un producto para terceros, usa autenticación con API key: Anthropic no permite ofrecer el login de claude.ai en productos de terceros sin aprobación previa.
Paso 2: el orquestador solo, antes que nada
El error más común es diseñar el equipo entero antes de que funcione un solo agente. Arranca el orquestador sin especialistas, comprueba que la tarea se puede hacer y apunta dónde tuvo problemas, dónde gastó más tokens y qué partes eran independientes. Esas notas son tu diseño de equipo: lo independiente se convierte en especialistas en paralelo y lo flojo, en trabajo del crítico.
Paso 3: define especialistas con permisos mínimos
Los subagentes se definen con AgentDefinition y se pasan en agents. Los campos obligatorios son description y prompt, y el que más se descuida es description: el orquestador lo lee para decidir cuándo delegar. “Ayuda con la investigación” no enruta nada. “Busca y verifica datos sobre una pregunta concreta” sí.
Dos detalles que suelen fallar:
- El orquestador necesita
Agentenallowed_tools, porque los subagentes se invocan con esa herramienta. - Si quieres asegurarte de que se usa un especialista, nómbralo en el prompt: “Usa el agente critic para revisar el borrador”.
Combinaciones de herramientas que propone la documentación como punto de partida:
| Rol | Herramientas | Qué puede hacer |
|---|---|---|
| Análisis de solo lectura | Read, Grep, Glob | Examinar sin modificar ni ejecutar |
| Ejecución de tests | Bash, Read, Grep | Ejecutar comandos y analizar la salida |
| Modificación de código | Read, Edit, Write, Grep, Glob | Leer y escribir, sin ejecutar |
Aplícalo a cada rol. El crítico solo lee, porque si puede editar “arreglará” cosas en silencio en vez de señalarlas. El investigador busca y lee, pero no escribe. Solo el agente que produce el fichero tiene Write.
Paso 4: resuelve el traspaso de contexto
Aquí se rompen la mayoría de los primeros equipos. Un subagente empieza con el contexto limpio: no ve el historial del orquestador, ni sus resultados de herramientas, ni su system prompt. Lo único que recibe del agente principal es el texto que le pasa al invocarlo. Si el orquestador delega con “ahora redáctalo”, el escritor no sabe qué es “lo”.
Pon esto en las instrucciones del orquestador:
Cuando delegues, escribe a cada subagente un encargo completo. Incluye cada ruta
de fichero, hallazgo, decisión y restricción que necesite. Da por hecho que no ha
visto nada de esta conversación.
Y al revés: el orquestador recibe el mensaje final del subagente, pero puede resumirlo. Si necesitas una salida literal, díselo expresamente.
Paso 5: el crítico, el effort y los topes
El crítico se define igual que el resto, pero con herramientas de solo lectura:
critic = AgentDefinition(
    description="Revisa un borrador terminado contra los hallazgos de los que sale. "
                "Úsalo tras cada borrador, antes de dar nada por final.",
    prompt="""Revisas un borrador contra los hallazgos de los que se escribió.
Comprueba que cada afirmación factual aparece en los hallazgos.
Comprueba que nada marcado como NO VERIFICADO se presenta como hecho.
Devuelve PASS, o FAIL seguido de una lista numerada de correcciones concretas.
Nunca editas el borrador tú mismo.""",
    tools=["Read"],
    effort="medium",
)
Limita el bucle: un escritor y un crítico que no se ponen de acuerdo te queman el presupuesto discutiendo. Indica al orquestador que pare tras tres rondas y devuelva el mejor borrador con las objeciones pendientes.
AgentDefinition acepta un campo effort (low, medium, high, xhigh o max), así que puedes ajustarlo por rol: low para investigadores y trabajadores simples, y medium para escritor, crítico y orquestador. Anthropic recomienda reservar xhigh y max para donde hayas medido una mejora real.
Después, fija los tres topes que ofrece el SDK:
options = ClaudeAgentOptions(
    model="claude-opus-5-5",
    allowed_tools=["WebSearch", "WebFetch", "Write", "Agent"],
    agents={"researcher": researcher, "writer": writer, "critic": critic},
    env={
        "CLAUDE_CODE_MAX_SUBAGENT_SPAWN_DEPTH": "1",   # los especialistas no crean subagentes
        "CLAUDE_CODE_MAX_CONCURRENT_SUBAGENTS": "5",   # máximo 5 a la vez
    },
    max_budget_usd=5.0,
)| Límite | Por defecto | Qué pasa al alcanzarlo |
|---|---|---|
| Profundidad | 3 niveles | El subagente del último nivel no puede crear más y hace el trabajo él mismo |
| Concurrencia | 20 subagentes | Se rechaza lanzar otro hasta que baje el número |
| Gasto | Sin límite | No se lanzan más subagentes, se paran los que siguen en segundo plano y la consulta termina con error_max_budget_usd |
Fíjate en el último: tu primera ejecución no tiene techo de gasto si no lo pones tú.
Paso 6: dale un reloj al equipo
Este es el hallazgo más interesante de la guía de Opus 5.5. Si puedes estimar cuánto debería durar la tarea, haz que tu harness añada al final de cada mensaje una línea con el tiempo transcurrido frente al presupuesto, por ejemplo elapsed 340s / 1200s. Si no puedes estimarlo, muestra solo el tiempo transcurrido y añade esto al system prompt:
Time matters here: do not spend time that can be avoided, and the earlier a correct
result is obtained, the better.
En las evaluaciones de Anthropic con equipos pequeños en tareas de investigación, los equipos con presupuesto mantuvieron una calidad comparable a la de un solo agente y terminaron bastante antes. Pero el presupuesto es orientativo: nada detiene al modelo al llegar al límite. Pon tu propio timeout:
try:
    await asyncio.wait_for(run_team(), timeout=1200)
except asyncio.TimeoutError:
    print("Parada forzada. Revisa drafts/ para la salida parcial.")
Paso 7: que no se pare antes de tiempo
Opus 5.5 va informando mientras trabaja, y algunas de esas actualizaciones terminan el turno con texto en lugar de con una llamada a herramienta. En un bucle desatendido, eso detiene el trabajo: el orquestador escribe un buen resumen anunciando lo que va a hacer y no lo hace.
La guía de Anthropic describe cuatro patrones de parada temprana: un resumen que anuncia el siguiente paso sin ejecutarlo, ofrecerse a continuar salvo que digas lo contrario, una lista de decisiones que en realidad no bloquean nada y decidir que un hito es buen momento para informar. El modelo responde bien a instrucciones que nombran esos patrones, así que nómbralos en el system prompt del orquestador. Mantén además las tareas en una checklist que el modelo actualice y, si tu harness envía continuaciones automáticas, para tras dos o tres para que una ejecución atascada no entre en bucle.
Los errores que matan a un equipo
- Montar cinco agentes antes de que funcione uno.
- Descripciones vagas que el orquestador no sabe cuándo usar.
- Traspasos pobres: “redáctalo” sin datos.
- No tener crítico: la velocidad en paralelo sin revisión solo produce errores más rápido.
- Dar todos los permisos a todos.
- No poner tope de gasto.
- Fiarse del reloj orientativo en vez de un timeout real.
- Dejar que el equipo haga cosas irreversibles. Redactar un email es delegar; enviarlo es tu decisión. Enviar, publicar, gastar o borrar, siempre detrás de una aprobación humana.
El código de esta guía se escribe en una tarde. Lo difícil es saber describir paso a paso cómo se hace tu tarea: si no puedes explicárselo a un agente, tampoco se lo vas a poder explicar a cinco. Si trabajas desde el editor en vez de desde el SDK, puedes aplicar la misma idea con varios agentes en Orca.
¿Te ha servido? Márcanos como fuente preferida en Google y verás antes nuestros artículos en Noticias destacadas, AI Overviews y AI Mode.
📎 Fuente original: X / @eng_khairallah1 ↗